01
Parser
문서와 데이터를 읽고 정리합니다.
문서·데이터베이스·업무시스템에서 필요한 정보를 수집하고 추출합니다.OCR로 스캔한 문서의 글자를 읽고, 새로 들어오는 데이터를 정리하는 파이프라인을 구성합니다.
- 데이터 수집·추출·정리
- OCR을 활용한 문서 정보 활용
- 새 데이터를 수집·정리하는 흐름
흩어진 데이터를 정리하고, 업무에 필요한 지식을 검색하며, Agent가 기존 시스템의 기능을 실행하도록 구성합니다.
자료와 지식, 모델과 도구를 업무에 맞게 연결합니다. 각각의 작업을 조율하고, 실행부터 운영까지 하나의 흐름으로 구성합니다.
8개 영역 · 32개 구성 항목. 확장 검토 항목을 포함한 설계안으로, 실제 적용 기능과 제공 범위는 제품·도입 구성에 따라 정합니다.
문서·데이터베이스·업무시스템에서 필요한 정보를 수집하고 추출합니다.OCR로 스캔한 문서의 글자를 읽고, 새로 들어오는 데이터를 정리하는 파이프라인을 구성합니다.
질문과 관련된 사내 자료를 찾아 AI가 답변에 활용하도록 합니다.문서를 의미에 따라 찾을 수 있는 검색용 데이터로 바꾸고(임베딩), 필요한 정보와 출처를 검색합니다.
AI가 찾은 정보와 회사 프로그램의 기능을 사용해 정해진 일을 수행하도록 구성합니다. 수행할 업무와 사용할 기능, 실행 권한을 먼저 정합니다.
보유 문서와 업무 기준을 바탕으로 검색·정리 업무를 구성하고, 필요한 시스템을 연결해 담당자 확인 이후의 업무로 이어갈 수 있습니다.
업무의 목적과 적용 방식,
도입으로 달라지는 일을 함께 살펴봅니다.
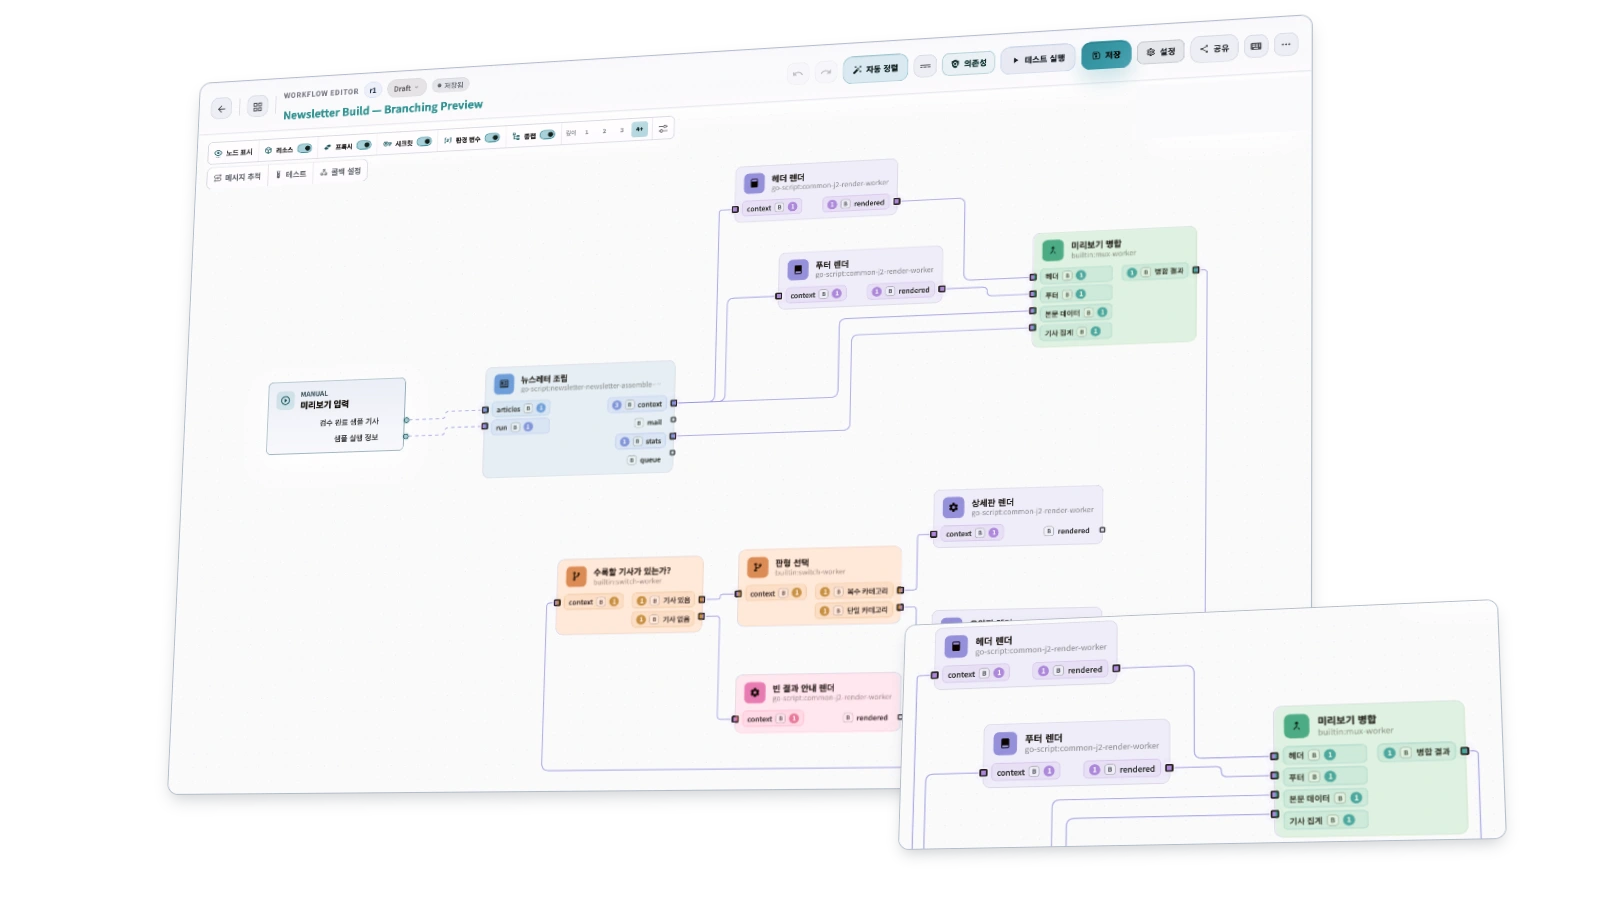
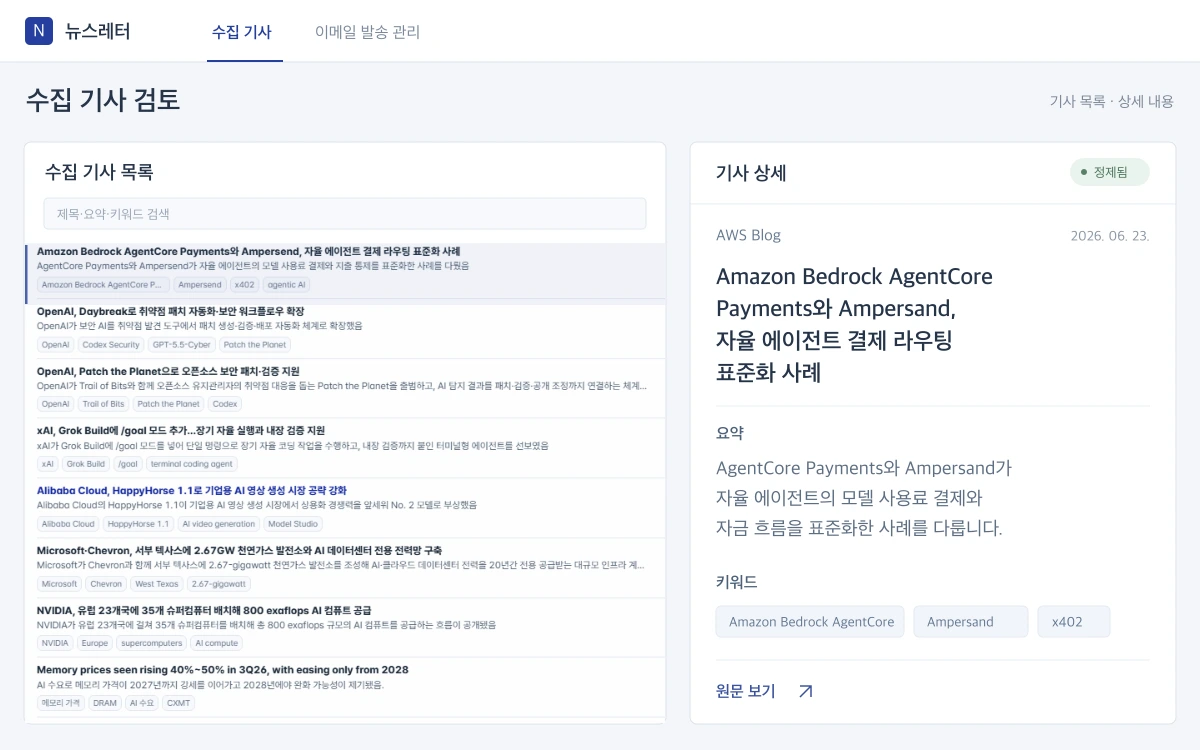
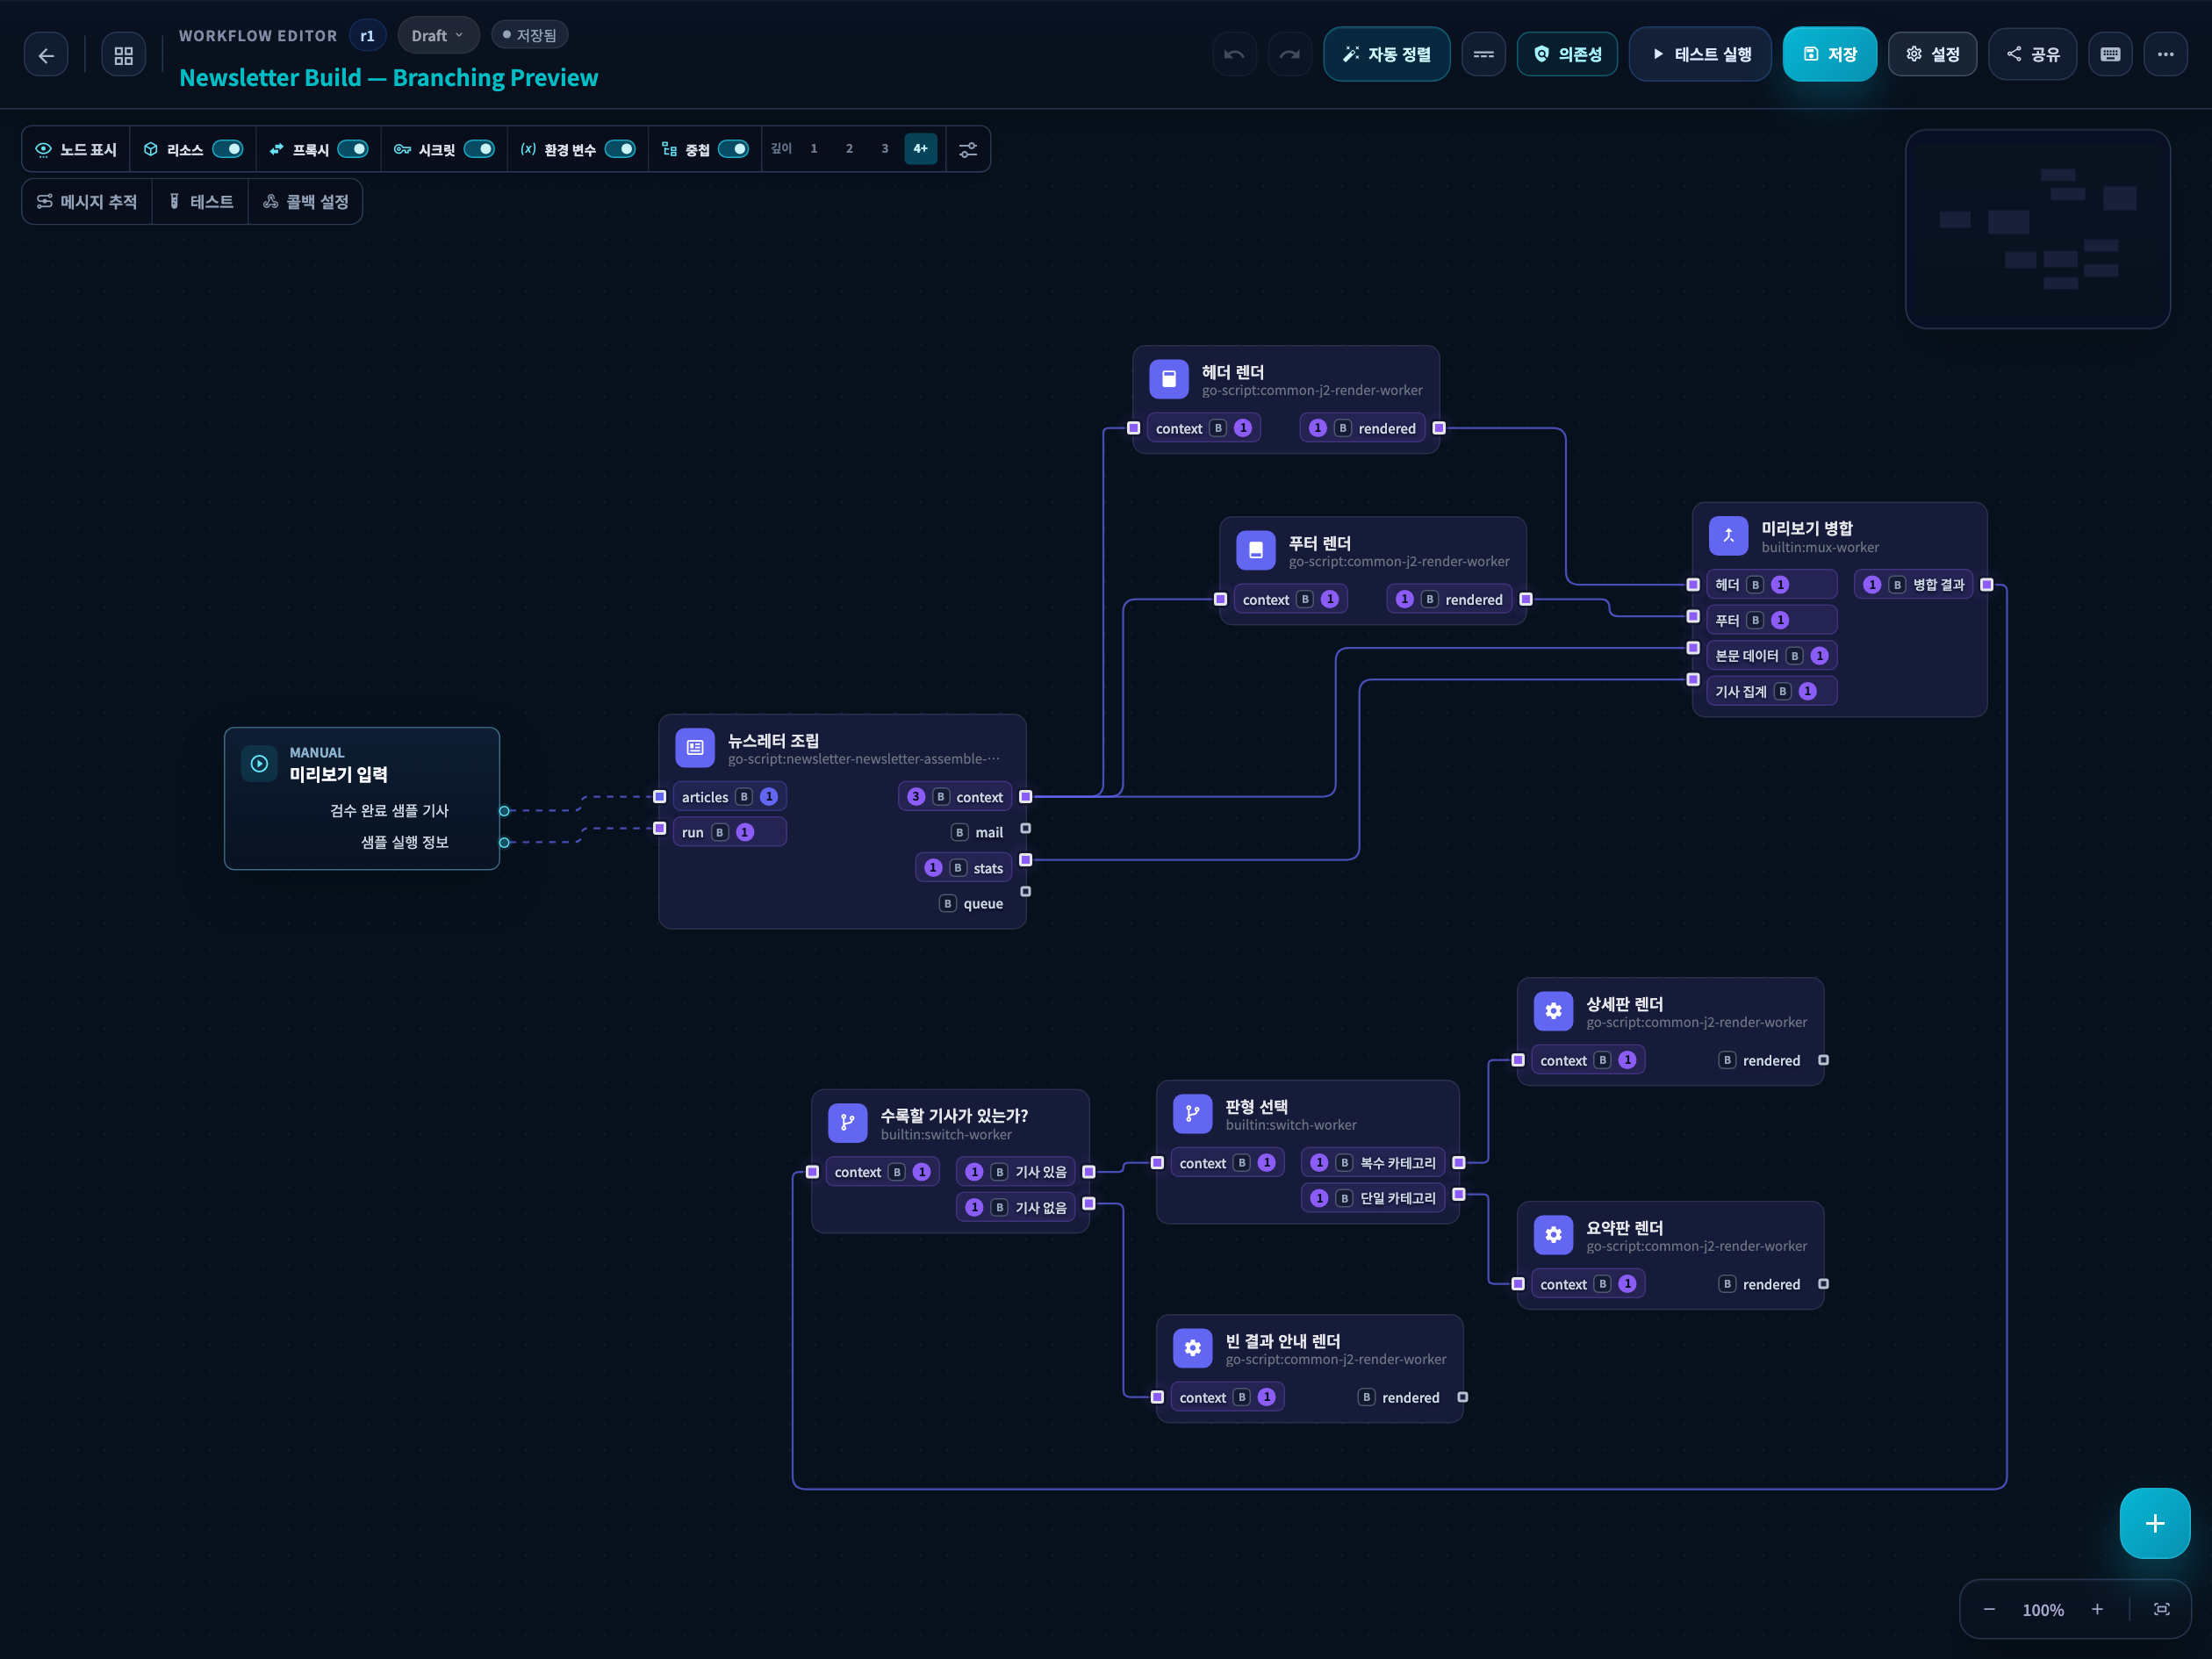
뉴스레터 작성
기사 확인과 판형 선택, 본문·상단·하단 영역의 구성을 하나의 작성 흐름으로 연결합니다.
구현한 업무 변화
상세판·요약판의 작성 흐름을 같은 워크플로로 관리하고, 담당자는 합쳐진 미리보기로 결과를 확인합니다.
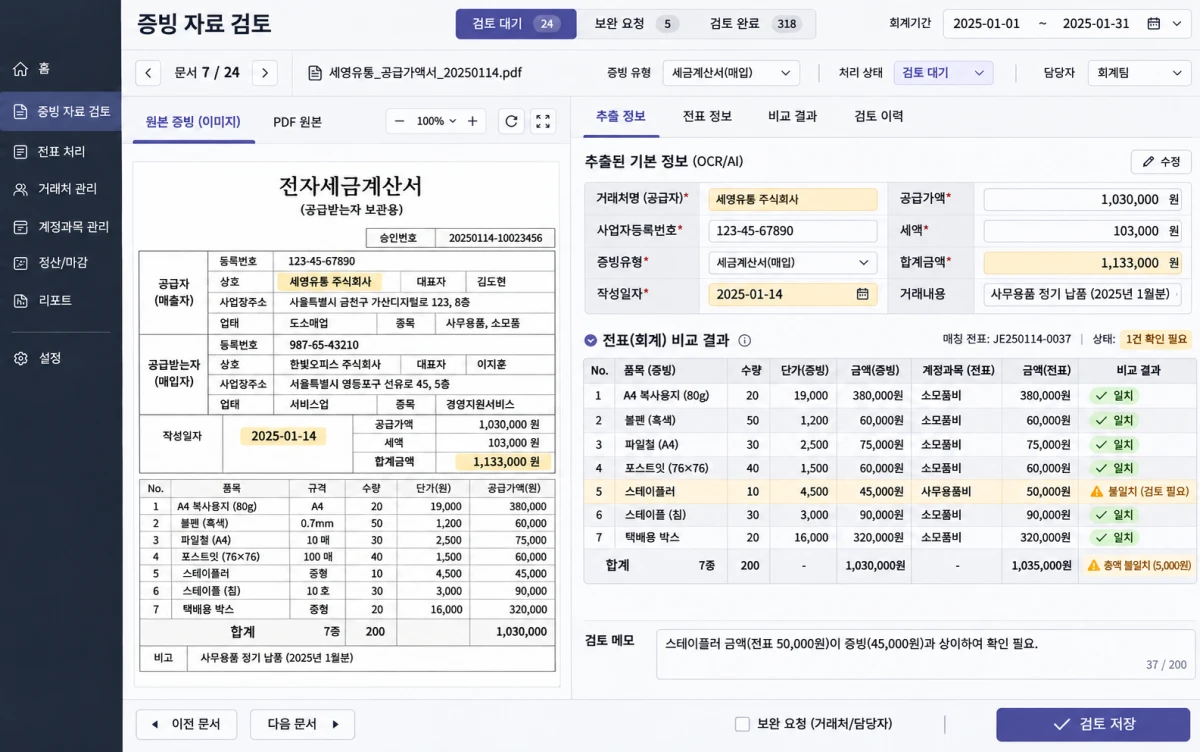
재무자동화
재무 업무에서 반복되는 자료 처리에 AI를 적용하고, 담당자가 결과를 확인하는 흐름을 다룹니다.
기대 효과
같은 자료를 되풀이해 정리하는 작업을 줄이고, 담당자가 확인해야 할 결과와 근거에 집중할 수 있는 업무 흐름을 목표로 합니다.
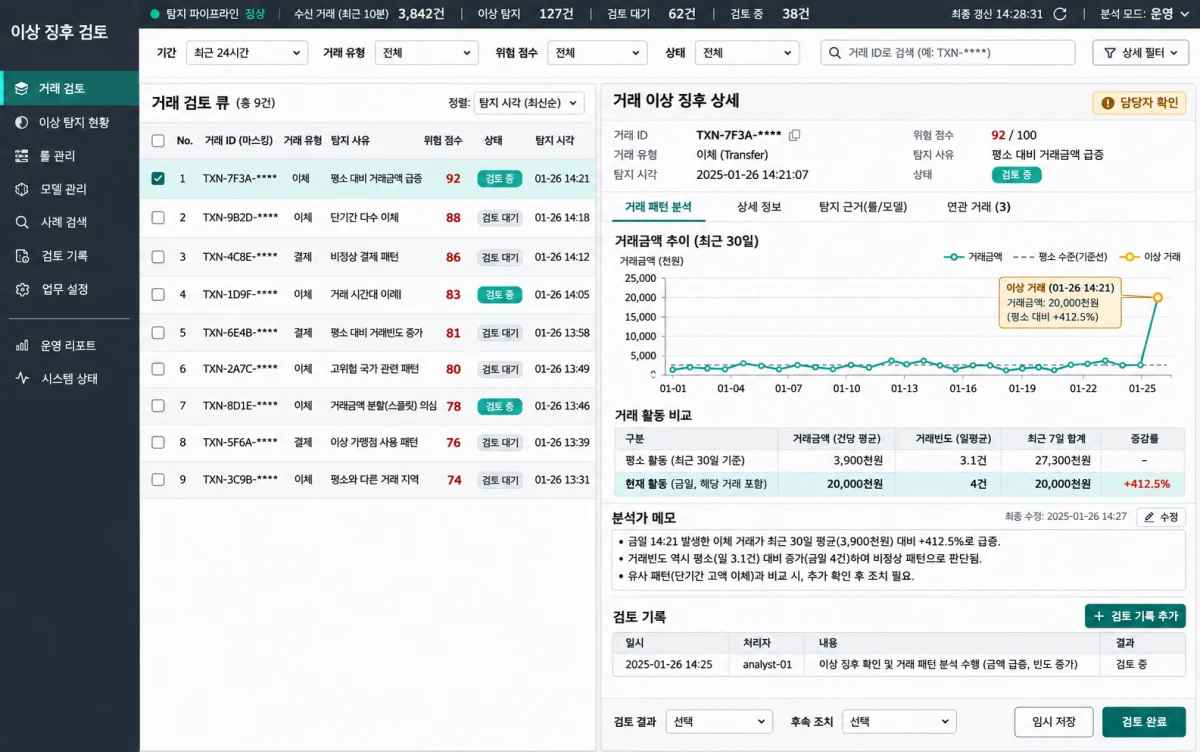
AI FDS
금융거래에서 이상 징후를 찾아내는 AI 기반 이상금융거래 탐지 시스템을 다룹니다.
기대 효과
거래 정보를 일일이 살펴보는 부담을 덜고, 탐지 결과를 바탕으로 확인과 후속 판단을 이어갈 수 있는 운영을 목표로 합니다.
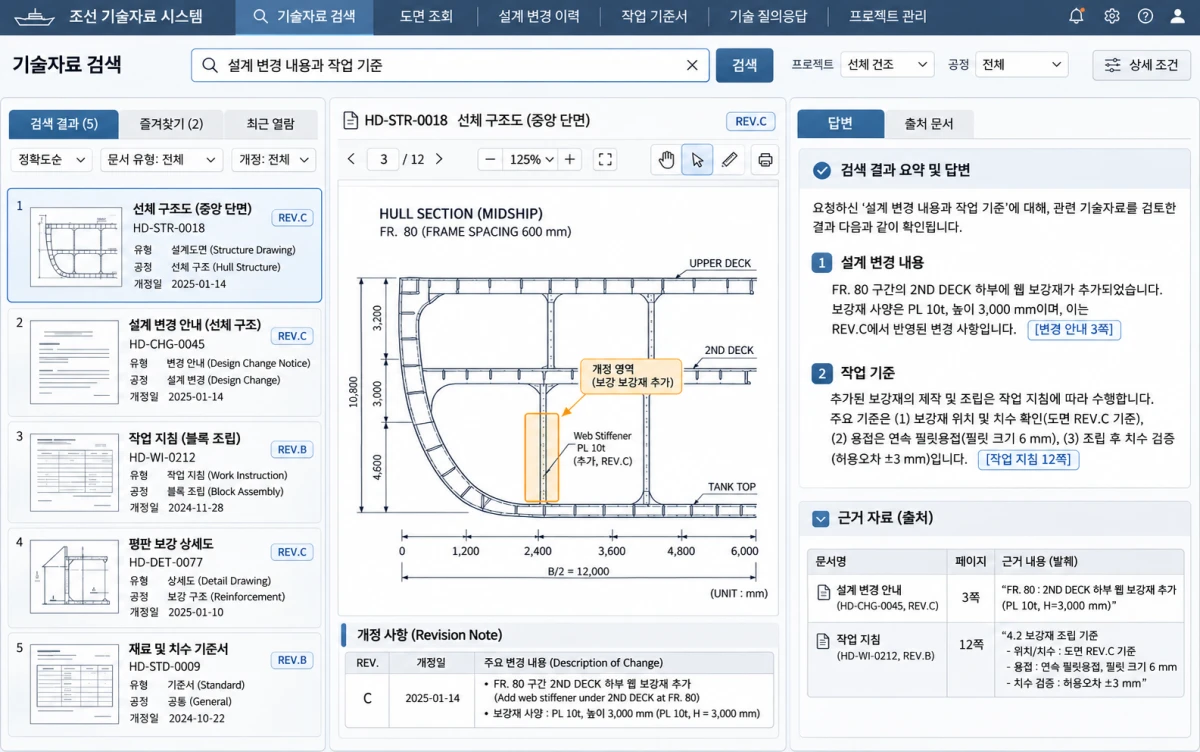
조선 분야 RAG
조선 분야 자료를 검색하고 관련 내용을 AI 답변에 활용하는 검색 증강 생성 방식입니다.
기대 효과
찾아볼 자료의 범위를 좁히고 답변과 관련 문서를 함께 살펴, 전문 정보의 확인과 활용을 돕는 것이 목적입니다.
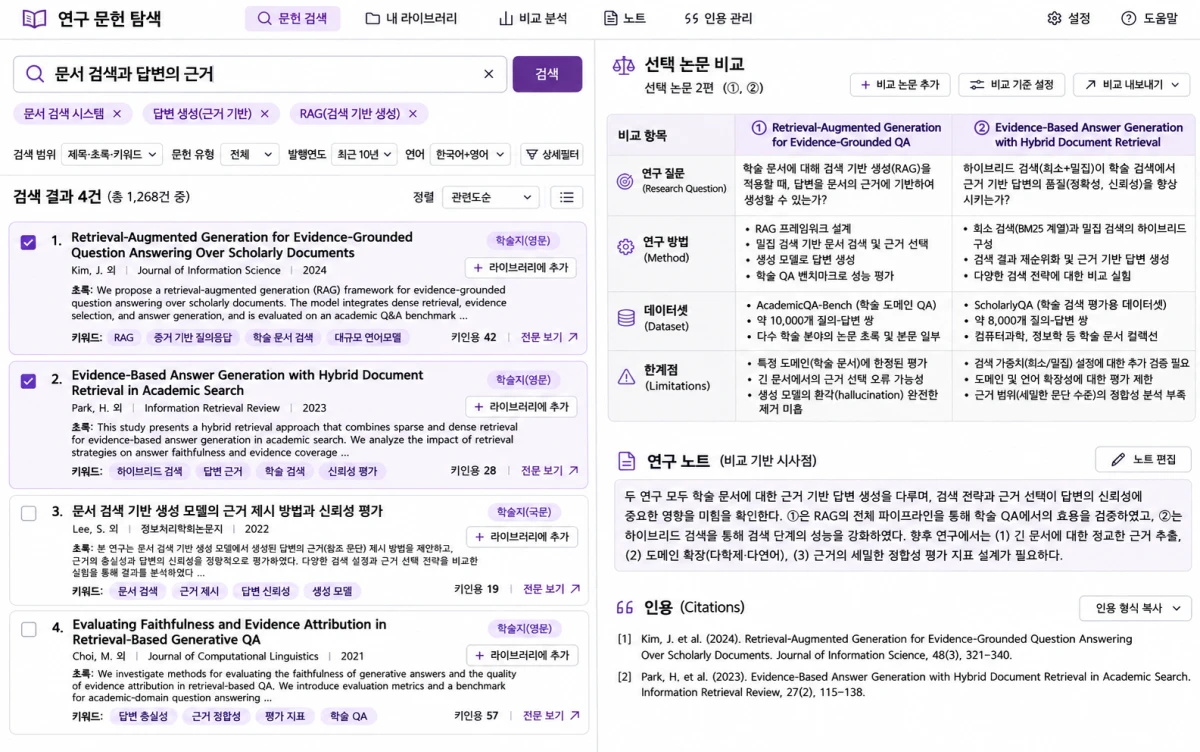
논문 연구 RAG 시스템
논문 자료 검색과 근거 확인에 RAG를 적용해 연구자의 자료 검토를 지원합니다.
기대 효과
논문 자료를 하나씩 찾는 반복을 덜고, 질문에 맞는 자료와 근거를 바탕으로 후속 검토를 이어갈 수 있도록 돕습니다.
대상 업무, 문서·데이터, 연결할 시스템과 권한을 살핍니다.
필요한 Parser·RAG·Agent와 Orchestration 범위를 정합니다.
업무 질문과 테스트 자료로 검색 근거·답변·작업 결과를 확인하고, 실행 권한을 검증합니다.
자료 갱신, 실행 이력, 오류 대응과 담당자의 확인 기준을 정하고 적용 범위를 넓힙니다.
지원 문서 형식·OCR 환경·모델·배포 방식·시스템 연계는 도입 범위별로 확인합니다.